Vídeo com IA
Prompt para vídeo com IA: como escrever e 9 exemplos prontos
A estrutura que tira o vídeo do genérico: o que descrever, em que ordem, como falar a língua da câmera e como corrigir um resultado ruim sem recomeçar do zero.
Em resumo
- Um prompt para vídeo com IA descreve sujeito, ação, cenário, câmera, lente, luz e estilo e, quando a ferramenta gera som, o áudio.
- Peça uma única ação por clipe e dê nome e velocidade ao movimento de câmera.
- No imagem para vídeo, descreva só o movimento: a imagem já define personagem, cenário e luz.
- Troque “sem” e “não” por descrições positivas ou pelo campo de prompt negativo.
- Mude uma variável por vez e guarde cada versão até o prompt funcionar.
Um bom prompt para vídeo com IA diz quem aparece, o que faz, onde a cena acontece, como a câmera se move e com que luz e estilo. Se a ferramenta gera som, diz também o que se ouve. A diferença para o prompt de imagem é o tempo: você não descreve uma foto, dirige uma ação que começa e termina em poucos segundos.
Uma ação por clipe, câmera com nome técnico e uma mudança por tentativa resolvem a maior parte dos resultados genéricos. Se você ainda está escolhendo ferramenta ou montando o fluxo do roteiro ao vídeo final, comece pelo guia de como criar vídeos com IA.
Anatomia de um prompt para vídeo com IA
“Um pescador velho num barco” deixa a IA decidir sozinha enquadramento, luz, ritmo e movimento, e ela escolhe a média de tudo o que já viu. Cada elemento da tabela é uma decisão que você toma no lugar dela. O guia oficial de prompts do Veo, do Google organiza o prompt quase nesses mesmos blocos.
| Elemento | O que responder | Exemplo |
|---|---|---|
| Sujeito | Quem ou o que aparece, com detalhes visíveis | “pescador de 70 anos, gorro de lã azul” |
| Ação | O que muda do primeiro ao último segundo | “vira o rosto devagar para o mar” |
| Cenário | Onde e quando | “convés de um barco, fim de tarde” |
| Câmera | Ângulo, enquadramento e movimento | “close-up, dolly in lento” |
| Lente | Como a imagem é captada | “teleobjetiva, fundo desfocado” |
| Luz | De onde vem e de que cor é | “luz fria de céu nublado” |
| Estilo | Que tipo de imagem é | “filme de época, granulação” |
| Clima | A emoção da cena | “melancólico” |
| Tempo e ritmo | Velocidade da ação e da câmera | “câmera lenta” |
| Áudio | O que se ouve, em frase separada | “vento forte, ondas no casco” |
Sujeito, ação, cenário e câmera são o mínimo para sair do genérico. Uma ordem que funciona: sujeito e ação, cenário, câmera e lente, luz e estilo, e o áudio por último.
Genérico:
Um pescador velho num barco.

Dirigido:
Um pescador de 70 anos, barba branca e gorro de lã azul, segura um cachimbo no convés de um barco de madeira e vira o rosto devagar para o mar. Fim de tarde nublado, ondas altas ao fundo. Close-up em leve contra-plongée, dolly in lento. Lente teleobjetiva, fundo desfocado. Luz fria e difusa, tons de verde e cinza, estilo filme de época com granulação. Clima melancólico.
Áudio: vento forte, ondas batendo no casco, madeira rangendo.
Uma ação por clipe
Os clipes são curtos: em outubro de 2026, o Kling 3.0 gera de 3 a 15 segundos, segundo o guia oficial. Se a pessoa precisa entrar, sentar, abrir uma carta e chorar, a IA comprime tudo e algo sai errado. O guia de boas práticas do Google recomenda o mesmo: um momento por vídeo e eventos encadeados divididos em clipes.
Quais ferramentas geram som
Em outubro de 2026, geram som junto com a imagem o Veo 3 e o 3.1, do Google (efeitos, ambiente e diálogo), o Kling a partir da versão 2.6, que tem uma chave de áudio nativo, e o Seedance 2.0, da ByteDance. A Higgsfield reúne vários desses modelos, então o som depende do modelo escolhido. Se a ferramenta não gera som, deixe o áudio de fora e faça a trilha na edição.
Prompt de texto para vídeo e de imagem para vídeo
No texto para vídeo, o prompt é tudo o que a IA tem: você descreve sujeito, cenário, luz e estilo, porque ninguém mais vai fazer isso.
No imagem para vídeo, personagem, roupa, cenário e luz já estão no quadro. Descrever tudo de novo cria duas instruções competindo, e a IA pode alterar o rosto ou a roupa para encaixar o texto. O guia de boas práticas do Google é direto: escreva só o movimento e chame o personagem de forma genérica, como “a pessoa”. O prompt responde três perguntas: o que o sujeito faz, o que o ambiente faz e o que a câmera faz.
A pessoa vira o rosto devagar em direção à câmera e sorri de leve. O vento move o cabelo e a cortina ao fundo. A câmera faz um dolly in lento até um close-up. Movimento suave e natural.Vocabulário de câmera em português e inglês
Os termos de câmera em inglês são o padrão da indústria e das documentações oficiais. Na dúvida, escreva em português e mantenha o termo técnico em inglês: “a câmera faz um dolly in lento”.
| Em português | Em inglês | O que a câmera faz | Quando usar |
|---|---|---|---|
| Dolly in / out | dolly in, dolly out, push in | Anda na direção do sujeito ou se afasta dele | Criar tensão; revelar o lugar |
| Travelling | tracking shot, truck left/right | Desliza de lado ou acompanha o sujeito | Seguir alguém andando |
| Panorâmica | pan left/right | Gira para os lados sem sair do lugar | Mostrar uma paisagem |
| Tilt | tilt up/down | Gira para cima ou para baixo, parada | Revelar um prédio de baixo para cima |
| Órbita | arc shot, orbit | Circula em volta do sujeito | Produto, momento de impacto |
| Grua | crane shot, crane up/down | Sobe ou desce no ar | Abrir ou fechar uma cena com grandiosidade |
| Câmera na mão | handheld, shaky cam | Tremores leves, como alguém filmando | Realismo, vlog, documentário |
| Drone e FPV | drone shot, FPV drone shot | Voo aéreo; o FPV mergulha rápido, rente aos obstáculos | Paisagem, perseguição |
| Plano-sequência | one continuous long take | Um único plano, sem cortes | Cenas que pedem continuidade |
| Zoom | zoom in/out, crash zoom | A lente aproxima sem a câmera andar; o crash zoom é brusco | Humor, susto, trend |
| Câmera parada | static shot | Nenhum movimento | Diálogo, produto |
Além do movimento, nomeie enquadramento, ângulo e lente:
- Enquadramento: close-up, plano detalhe (“extreme close-up”), plano médio (“medium shot”), plano geral (“wide shot”), por cima do ombro (“over-the-shoulder shot”), ponto de vista (“POV shot”).
- Ângulo: plongée (“high-angle shot”), contra-plongée (“low-angle shot”), zenital (“top-down shot”), altura dos olhos (“eye-level shot”).
- Lente: grande-angular (“wide-angle lens”), teleobjetiva (“telephoto lens”), olho de peixe (“fisheye lens”), fundo desfocado (“shallow depth of field”), troca de foco (“rack focus”), efeito vertigem (“dolly zoom”).
Como pedir o que você não quer no vídeo
“Sem pessoas ao fundo” costuma sair pela culatra: o modelo lê “pessoas” e às vezes as coloca na cena. O guia do Veo recomenda não usar “não” ou “sem” nas instruções e listar o que você não quer ver no campo de prompt negativo.
Nesse campo, escreva só substantivos e características: “texto, legenda, marca d’água, dedos extras, rosto deformado, tremor”. Nem toda interface mostra o campo; procure nas opções avançadas. Sem ele, troque a proibição por uma descrição positiva:
| Em vez de | Escreva |
|---|---|
| “sem pessoas” | “rua completamente vazia, deserta” |
| “não tremer a câmera” | “câmera estável, em tripé” |
| “sem cortes” | “um único plano contínuo” |
| “sem música” | “apenas som ambiente de chuva” |
| “não deformar o rosto” | “movimentos lentos” e “rosto deformado” no negativo |
Letras e legendas aleatórias têm outra causa comum: aspas. O Google observa que aspas em falas podem fazer o Veo escrever o texto na imagem.
Método de iteração: mude uma variável por vez
O primeiro resultado raramente é o final. O que separa quem acerta em três tentativas de quem gasta vinte é método.
Escreva um prompt base completo
Use os elementos da primeira tabela. Esse é o V1.
Gere duas ou três versões antes de julgar
O mesmo prompt dá resultados diferentes a cada geração. Se uma versão acertou, o prompt está bom. Se nenhuma acertou, o problema está no texto.
Dê nome ao defeito
Câmera errada, rosto que mudou, luz estranha, movimento rápido demais. O nome do problema diz qual frase mexer.
Mude uma variável só
Movimento rápido? Troque “dolly in” por “dolly in muito lento” e mais nada. Se você mexe em câmera, luz e estilo de uma vez, não sabe o que resolveu.
Guarde cada versão
Numa planilha: versão, ferramenta e modelo, duração, formato, prompt, o que mudou e nota de 1 a 5. Se a ferramenta mostra o seed (número da semente), anote; o Google recomenda repetir o seed para manter a consistência.
Quando acertar, congele o prompt
Ele vira modelo para os próximos clipes. Troque sujeito e ação e mantenha câmera, luz e estilo, para que tudo pareça do mesmo filme.
Prompt para Kling, Veo 3, Seedance e Higgsfield: o que muda
Um prompt que funciona no Kling não sai igual no Veo. O exemplo mais claro é o diálogo: o Google pede a fala sem aspas; o Kling, com aspas.
| Ferramenta | O que a fonte oficial diz | Na prática |
|---|---|---|
| Veo 3 e 3.1 (Google) | Fala depois de dois-pontos, sem aspas; áudio em frases separadas; evitar “não” e “sem” | O detetive diz: Você chegou tarde. |
| Kling 3.0 | Personagem, tom entre parênteses e fala entre aspas; voz em chinês, inglês, japonês, coreano e espanhol (outros idiomas viram inglês) | Detetive (em voz baixa, irritado): “Você chegou tarde.” |
| Seedance 2.0 | Aceita texto, imagem, áudio e vídeo como referência e gera áudio e vídeo juntos | Diga o papel de cada referência: personagem, cenário ou movimento |
| Higgsfield | Reúne vários modelos, como Kling, Veo e Seedance, e oferece predefinições de câmera | Siga as regras do modelo escolhido |
Ao trocar de ferramenta, teste o prompt congelado antes de produzir em série e confira a documentação da versão que você usa, porque essas regras mudam a cada lançamento. O guia oficial do Kling 3.0 e o do Veo, citado acima, são bons pontos de partida.
9 prompts para vídeo com IA: viral, realista, profissional e mais
Use estes prompts para vídeos de IA como ponto de partida: troque sujeito, cenário e produto pelos seus e mantenha a estrutura. Os de diálogo e de múltiplos planos estão em inglês, com explicação abaixo. Se a ferramenta não gera som, apague a linha de áudio.
Uma mulher de 30 anos, capa de chuva amarela, para no meio de uma ponte de ferro e olha para trás, assustada. Noite chuvosa numa cidade portuária, neblina leve, poças refletindo os postes. Plano médio, câmera na mão discreta (handheld) com dolly in lento até um close-up do rosto. Lente 50 mm, fundo desfocado. Luz alaranjada contra o céu azul-escuro, estilo filme de suspense, granulação de película. Clima tenso.
Áudio: chuva batendo no metal, apito de navio distante, respiração ofegante.Um frasco de perfume de vidro âmbar com tampa dourada sobre uma pedra preta molhada. Gotas de água escorrem pelo vidro em câmera lenta. A câmera faz uma órbita lenta de 180 graus em volta do frasco (arc shot), na altura do produto. Fundo preto, luz de recorte nas bordas do vidro, reflexo suave na pedra. Estilo comercial de luxo, ritmo calmo.
Áudio: gotas caindo, um acorde grave e suave.Com a foto real do produto, use imagem para vídeo e mantenha só as frases de movimento, câmera e áudio: rótulo e formato não mudam. O guia de vídeo de produto com IA mostra o fluxo de um comercial.
Animação 3D em estilo de filme infantil, cores vivas. Uma raposa laranja de olhos grandes e cachecol verde tenta pegar uma folha que voa e tropeça num monte de folhas de outono. Floresta ensolarada, luz quente de fim de tarde entre as árvores. Plano geral com câmera parada (static shot), depois um zoom in suave no rosto surpreso da raposa. Movimentos elásticos e exagerados, como em desenho animado.
Áudio: folhas secas estalando, efeito sonoro cômico de mola no tombo.
Para outros estilos, como 2D e massinha, veja o guia de animação com IA.
Uma criadora de conteúdo de 25 anos, cabelo cacheado preso, camiseta branca, acena para a câmera, toma um gole de café e sorri, gesticulando como quem vai contar uma novidade. Cozinha de apartamento com sol da manhã entrando pela janela. Plano médio vertical, câmera na mão na altura do rosto, como selfie, com balanço leve. Luz natural, pele com textura real, estética de vídeo de celular. Clima descontraído.
Áudio: som ambiente de cozinha, cafeteira chiando.Vale de montanhas com neblina ao amanhecer, um rio sinuoso refletindo o céu rosado, pinheiros escuros em primeiro plano. O drone sobe devagar por trás dos pinheiros e revela o vale inteiro (crane up, drone shot). Plano geral, lente grande-angular, tudo em foco (deep depth of field). Luz dourada do sol nascendo atrás das montanhas, névoa se movendo devagar. Estilo documentário de natureza. Clima de calma e grandiosidade.
Áudio: pássaros, vento suave, água correndo ao longe.Um motociclista de jaqueta de couro preta acelera por uma estrada de terra no deserto e faz uma curva fechada, levantando poeira. Fim de tarde, sol baixo. Câmera FPV de drone voando rente ao chão logo atrás da moto e subindo no fim da curva (FPV drone shot). Movimento rápido e fluido, leve desfoque de movimento. Contraluz dourada, poeira iluminada, estilo filme de ação.
Áudio: motor roncando alto, cascalho batendo no metal, vento.No vídeo viral estilo trend, a ideia pesa mais que o acabamento: um contraste absurdo que se entende em um segundo, como um animal fazendo algo humano. O prompt garante a execução clara, com enquadramento marcante e uma ação só.
Um gato laranja gordo, de jaqueta de couro e óculos escuros, anda em direção à câmera numa calçada à noite e para encarando a lente, muito de perto. Lente olho de peixe (fisheye lens) quase colada no rosto do gato, câmera baixa, na altura do chão. Estética de vídeo de celular dos anos 2000, flash estourado, cores frias e granulação. Clima cômico e confiante. Vertical 9:16.
Áudio: passos leves, batida de hip-hop abafada vinda de um carro parado.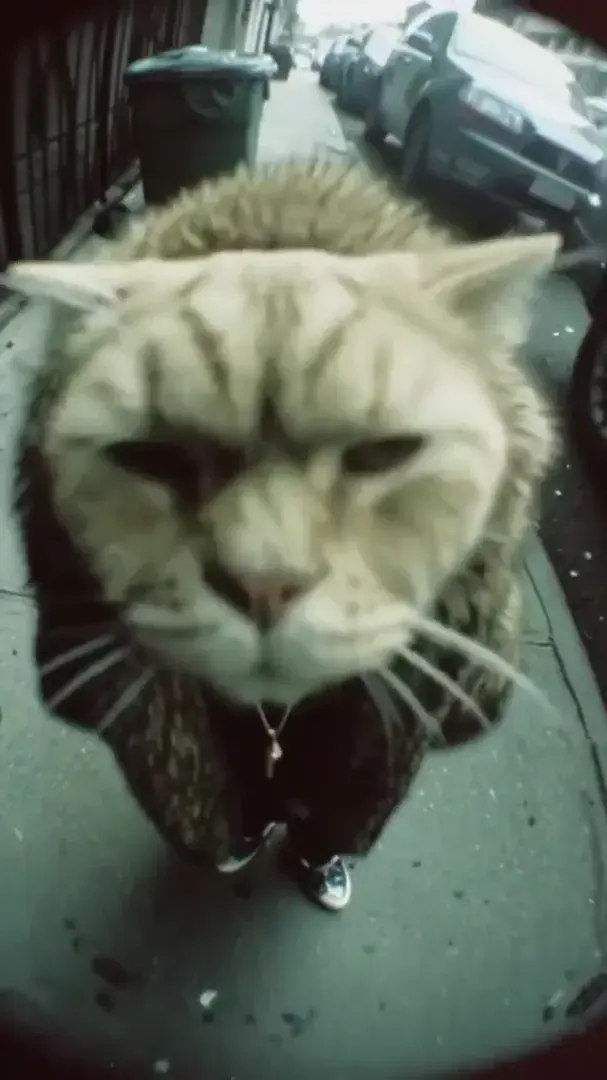
Medium shot in a small, dimly lit bookstore at night. An elderly bookseller with round glasses closes a heavy book and looks up at a young woman holding a wet umbrella. Static camera, warm lamp light, rain on the window behind them.
The bookseller says, in a calm, raspy voice: We closed an hour ago, but come in.
The young woman says, smiling and out of breath: Thank you, I only need one book.
Ambient sound: rain on the glass, a clock ticking.
A primeira frase monta a cena; cada fala vem depois de dois-pontos, sem aspas, com o tom de voz antes; o som ambiente fica numa frase própria. No Kling 3.0, use o formato do guia oficial: Bookseller (calm, raspy voice): “We closed an hour ago, but come in.” Para fala em português, teste antes uma frase curta: o guia do Kling 3.0 não lista o português, e o do Veo não traz lista de idiomas. Se não ficar bom, grave a voz à parte.
Shot 1: close-up of a barista's hands pouring milk into an espresso, forming a heart, steam rising, warm morning light.
Shot 2: medium shot, a customer at the counter takes the cup and smiles, handheld camera.
Shot 3: wide shot of the small café seen from the street through the window, slow dolly out.
Cozy natural colors, documentary style.
Ambient sound: espresso machine hissing, soft chatter, cups clinking.
No Kling 3.0, ative o modo de múltiplos planos (Multi-Shot); no modo personalizado você define quantos planos e quanto dura cada um. Cada plano tem uma ação e um enquadramento, e a linha final vale para todos.
Como usar o ChatGPT ou o Gemini para criar prompts de vídeo
O ChatGPT e o Gemini são ótimos para rascunhar: você descreve a ideia em linguagem comum e eles devolvem a cena estruturada. O próprio guia de boas práticas do Google sugere usar o Gemini para transformar uma ideia simples num prompt detalhado.
Uma ressalva para quem procura “prompt para criar vídeo no ChatGPT”: em março de 2026 a OpenAI anunciou o fim do app do Sora, seu gerador de vídeo. Use o ChatGPT para escrever o prompt e gere o vídeo numa ferramenta de vídeo. No app do Gemini, assinantes dos planos pagos do Google geram vídeo ali mesmo (em outubro de 2026, com o Gemini Omni, que está substituindo o Veo no app); confira o que o seu plano inclui.
Você é diretor de fotografia e especialista em prompts para vídeo com IA.
Transforme a ideia abaixo em um prompt para [Kling 3.0 / Veo 3.1 / Seedance 2.0], com até 120 palavras, em um parágrafo, nesta ordem: sujeito com detalhes visíveis, uma única ação, cenário e hora do dia, enquadramento e um movimento de câmera (termo em inglês entre parênteses), lente, luz, estilo e clima. Se a ferramenta gera som, acrescente uma frase separada para o áudio.
Use só o que a câmera consegue filmar, sem adjetivos vagos. Não inclua marcas, pessoas reais nem texto na tela.
Depois, sugira 3 variações mudando uma coisa só em cada: câmera, luz ou ritmo.
Duração: [5 ou 10] segundos. Formato: [9:16 ou 16:9].
Ideia: [descreva a cena em uma ou duas frases]
Antes de colar o resultado na ferramenta de vídeo, confira:
- Tem uma ação só, que cabe na duração do clipe?
- O movimento de câmera tem nome e velocidade?
- Os detalhes são visíveis (cor, material, idade, hora do dia)?
- O áudio está numa frase separada, e só se a ferramenta gera som?
- Ficou de fora qualquer marca, pessoa real ou texto na tela?
Perguntas frequentes
Qual a melhor IA para gerar vídeo a partir de prompt?
Depende da cena. Em outubro de 2026, Kling 3.0, Veo 3.1 e Seedance 2.0 são boas opções e todos geram som junto com a imagem; plataformas como a Higgsfield reúnem vários deles num lugar só. Rode o mesmo prompt em duas ou três ferramentas e compare movimento, rosto e som antes de escolher. Planos e créditos mudam com frequência, então confira no site de cada uma.
Prompt para vídeo com IA funciona em português?
Funciona na maioria das ferramentas. Os termos de câmera em inglês, como dolly in e tracking shot, são o padrão das documentações oficiais, então vale escrever em português e manter esses termos técnicos em inglês. Para falas, confirme os idiomas de voz: o guia oficial do Kling 3.0 não lista o português e traduz outros idiomas para o inglês.
Qual o tamanho ideal de um prompt para vídeo?
Na prática, entre 40 e 120 palavras resolve a maioria das cenas: cabe sujeito, ação, cenário, câmera, luz e estilo. Prompts muito longos acumulam instruções que se contradizem, e a IA acaba obedecendo só a uma delas. Se o texto não para de crescer, você provavelmente está descrevendo mais de uma ação e deveria dividir em dois clipes.
Dá para gerar vídeo com IA de graça?
Algumas ferramentas oferecem créditos gratuitos ou testes limitados, mas isso muda o tempo todo; confira no site de cada uma antes de assinar. Para treinar sem gastar, rascunhe os prompts no ChatGPT ou no Gemini, teste ideias em clipes curtos de 5 segundos e só gere a versão longa quando o prompt estiver aprovado.
Como manter o mesmo personagem em vários vídeos de IA?
Gere primeiro uma imagem do personagem e use imagem para vídeo em todos os clipes. Escreva também uma descrição fixa, com idade, cabelo, roupa e traços, e cole igual em todos os prompts, como recomenda o Google. Algumas ferramentas aceitam imagens de referência do personagem; o Kling 3.0, por exemplo, tem esse recurso.